Muuttujat ja mittaaminen data-analytiikassa

Muuttujat ja mittaaminen data-analytiikassa
Jokainen raportin, ennustemallin ja data-agentin luku on mittauksen tulos. Muuttujan mitta-asteikko kertoo, mitä luvulla saa laskea: lukumäärän, mediaanin, keskiarvon vai suhteen. Jos asteikkoa ei ole kirjattu, Power BI summaa vuosilukuja, raportti laskee keskiarvon tyytyväisyyskoodeista ja ennustemalli olettaa järjestyksen luokille, joilla sitä ei ole.
Mittaaminen alkaa käsitteestä
Raportit, ennusteet ja koneoppimismallit nojaavat siihen, miten ilmiö on mitattu. Mittaaminen rajaa siis, mittä data-analytiikalla voidaan saada aikaan. Liiketoiminnan käsitteestä päätökseen kulkee ketju, jonka jokaisessa vaiheessa merkitys voi kadota.
- Käsite on se, mitä halutaan tietää, esimerkiksi asiakastyytyväisyys tai aktiivinen asiakas.
- Operationaalinen määritelmä on sääntö, jolla käsite muutetaan havaittavaksi. Aktiivinen asiakas voi tarkoittaa ostoa viimeisen 12 kuukauden aikana tai voimassa olevaa sopimusta.
- Mittaus tuottaa arvon kyselyllä, järjestelmätapahtumalla, mittalaitteella tai laskennalla.
- Muuttuja on havaintoyksikön ominaisuus, joka saa eri arvoja. Havaintoyksikkö voi olla tilausrivi, tilaus tai asiakas, ja jos ne sekoittuvat, summat menevät väärin.
- Tunnusluku tiivistää monta arvoa yhdeksi luvuksi, kuten mediaaniksi tai konversioasteeksi. KPI lisää tunnuslukuun tavoitteen ja omistajan.
- Päätös on toimenpide, joka riippuu luvusta.
Kun kaksi tiimiä mittaa eri asioita samalla nimellä, raporttien luvut eroavat, vaikka jokainen laskenta olisi oikein.
Neljä mitta-asteikkoa
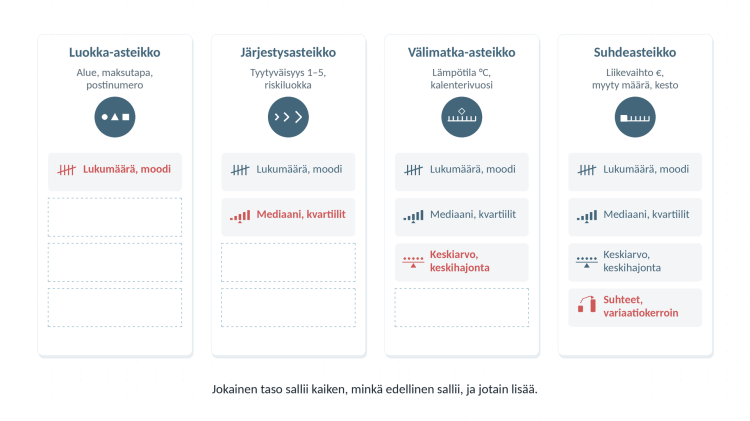
Psykologi Stanley Stevens jakoi mitta-asteikot vuonna 1946 neljään tasoon. Jaottelua on myöhemmin täydennetty ja kritisoitu, mutta se on yhä käytännöllisin tapa päättää, mitä muuttujalla saa laskea. Jokainen taso sallii kaiken, minkä edellinen sallii, ja jotain lisää.
Asteikko määräytyy sen mukaan, miten arvot syntyivät. Kokonaislukuna tallennettu postinumero on silti luokka, ja desimaalilukuna tallennettu tyytyväisyysarvio on silti järjestysluokka.
Luokka-asteikko
Luokka- eli nominaaliasteikollisen muuttujan arvot ovat nimiä ilman järjestystä. Esimerkkejä ovat alue, tuoteryhmä, maksutapa, asiakasnumero ja postinumero. Arvoista voi sanoa vain, ovatko ne samoja vai eri.
Sallitut tunnusluvut:
- havaintojen lukumäärä, frekvenssi ja prosenttiosuus
- moodi eli yleisin luokka
- kahden luokkamuuttujan yhteys: ristiintaulukointi, khiin neliö -testi, kontingenssikerroin tai Cramérin V
Asiakasnumeroiden summa näyttää datalta, mutta se ei tarkoita mitään. Tallenna luokkakoodit tekstinä, sillä kokonaislukuna postinumero 00180 muuttuu luvuksi 180.
Järjestysasteikko
Järjestys- eli ordinaaliasteikollisen muuttujan arvoilla on luonnollinen järjestys, mutta askelten etäisyyttä ei tunneta. Esimerkkejä ovat tyytyväisyys asteikolla 1–5, riskiluokka, tiketin prioriteetti ja koulutustaso. Askel "erittäin tyytymättömästä" "tyytymättömään" ei ole välttämättä yhtä suuri kuin askel "tyytyväisestä" "erittäin tyytyväiseen".
Edellisten lisäksi sallittuja ovat:
- mediaani, kvartiilit ja persentiilit
- minimi ja maksimi, koska ne tarvitsevat vain järjestyksen
- järjestyskorrelaatio, esimerkiksi Spearmanin tai Kendallin kerroin
Ilmoita kvartiilit luokkina, esimerkiksi "neutraalista tyytyväiseen", älä numeroiden erotuksena.
Välimatka-asteikko
Välimatka- eli intervalliasteikolla yhtä suuret erot tarkoittavat samaa koko asteikolla, mutta nollakohta on sovittu. Esimerkkejä ovat lämpötila celsiusasteina, kalenterivuosi ja päivämäärä.
Edellisten lisäksi sallittuja ovat:
- keskiarvo, keskihajonta ja varianssi
- vaihteluväli ja kvartiiliväli erotuksina
- Pearsonin korrelaatiokerroin, kun riippuvuus on lineaarinen
Suhteet eivät ole mielekkäitä, sillä 20 °C ei ole kaksi kertaa niin lämmin kuin 10 °C.
Suhdeasteikko
Suhdeasteikolla nolla tarkoittaa, ettei mitattavaa ole lainkaan, joten suhteet ja prosenttimuutokset ovat mielekkäitä. Liikevaihto euroina, myyty määrä, kesto, ikä, pituus ja energiankulutus kilowattitunteina ovat suhdeasteikollisia.
Edellisten lisäksi sallittuja ovat:
- prosenttimuutos ja suhdeluvut
- variaatiokerroin eli keskihajonta jaettuna keskiarvolla
- geometrinen ja harmoninen keskiarvo
Variaatiokerroin näyttää, miksi nollakohdalla on väliä. Lämpötiloista 10, 20 ja 30 °C saadaan keskiarvo 20, keskihajonta 10 ja variaatiokerroin 0,50. Samat lämpötilat fahrenheitasteina, 50, 68 ja 86 °F, antavat variaatiokertoimeksi noin 0,26. Sama data antaa kaksi eri vastausta, joten variaatiokerrointa ei lasketa välimatka-asteikolliselle muuttujalle.
Kolme kysymystä asteikon valinnasta
- Onko arvoilla mielekäs järjestys? Jos ei ole, muuttuja on luokka-asteikollinen.
- Tarkoittavatko yhtä suuret erot samaa koko asteikolla? Jos eivät, muuttuja on järjestysasteikollinen.
- Tarkoittaako nolla, ettei ilmiötä ole lainkaan? Jos ei, muuttuja on välimatka-asteikollinen, muuten suhdeasteikollinen.
Saman ilmiön voi mitata eri asteikoilla. Toimitusaika tunteina on suhdeasteikollinen, mutta luokittelu "ajallaan, myöhässä, paljon myöhässä" on järjestysasteikollinen. Valitse asteikko päätöksen tarpeen mukaan ja säilytä tarkempi mittaus aina, kun voit.
Keskiarvo vai mediaani?
Stevensin mukaan keskiarvo vaatii vähintään välimatka-asteikon. Tilastotieteilijät ovat kiistelleet säännöstä 1950-luvulta lähtien, ja keskiarvoa käytetään yleisesti tyytyväisyysasteikoille. Käytännöllinen testi on, pysyykö johtopäätös samana, kun arvot koodataan uudelleen toisilla numeroilla, jotka säilyttävät järjestyksen.
Tiimin A jäsenet vastaavat tyytyväisyyskyselyyn arvoilla 1, 4 ja 5, tiimin B jäsenet kaikki arvolla 3. Keskiarvo on A:lla 3,33 ja B:llä 3,00, joten A näyttää tyytyväisemmältä. Koodataan sitten "erittäin tyytymätön" arvoksi −2. Vastausten järjestys säilyy, joten koodaus on järjestysasteikolla yhtä pätevä, mutta A:n keskiarvo putoaa 2,33:een ja jää B:n alle. Mediaani on molemmilla koodauksilla A:lla 4 ja B:llä 3.
Tyytyväisyysarvioiden raportointiin riittää kolme sääntöä:
- Näytä ensin jakauma ja mediaani tai kahden parhaan vaihtoehdon osuus.
- Jos käytät keskiarvoa, kerro oletus ja tarkista, että johtopäätös pysyy samana mediaanilla.
- Kerro aina havaintojen määrä. 80 prosentin osuus viidestä vastauksesta on eri asia kuin 80 prosentin osuus viidestätuhannesta.
Mitta-asteikko Power BI:n semanttisessa mallissa
Power BI tekee koostevalinnat käyttäjän puolesta, joten asteikko pitää kirjata semanttiseen malliin. Asteikon lisäksi mittarilla on summattavuus, joka kertoo, minkä dimensioiden yli arvot saa laskea yhteen.
- Summautuvat mittarit, kuten myynti euroina ja myyty määrä, summautuvat kaikkien dimensioiden yli.
- Osittain summautuvat mittarit, kuten saldo, varasto ja henkilöstömäärä, summautuvat esimerkiksi tilien tai yksiköiden yli mutta eivät ajan yli. Kuukausittaisten henkilöstömäärien vuosisumma laskee jokaisen ihmisen kahteentoista kertaan.
- Ei-summautuvat mittarit, kuten yksikköhinta, konversioaste ja lämpötila, lasketaan summatuista osistaan, tai niistä näytetään keskiarvo, minimi tai maksimi.
Myymälässä A on 100 käyntiä ja 50 konversiota (50 %), myymälässä B 1 000 käyntiä ja 10 konversiota (1 %). Osuuksien keskiarvo on 25,5 %, mutta kaikista käynneistä 60 / 1 100 eli 5,5 % päättyi konversioon. Konversioaste lasketaan siksi summista eikä osuuksien keskiarvona.
Power BI -mallissa asteikko kirjataan neljällä tavalla:
- Summarization: Microsoft suosittelee arvoa Don't summarize vuosi-, kuukausi-, päivä- ja tunnistesarakkeille, koska Power BI summaa numeeriset sarakkeet oletuksena.
- Data category: tietoluokka kertoo, että kokonaislukusarake sisältää esimerkiksi postinumeroita.
- Sort by column: tekstinimikkeet järjestetään numeerisen järjestyssarakkeen mukaan. Muuten kuukaudet ja tyytyväisyysluokat järjestyvät aakkosiin.
- DAX-mittarit: eksplisiittinen mittari laskee oikean koosteen, kuten summista lasketun osuuden tai kauden viimeisen saldon. Sarakkeet, joita ei saa summata, piilotetaan.
Copilot ja Fabricin data-agentit kysyvät dataa saman semanttisen mallin kautta, joten mallin koostevirheet näkyvät myös niiden vastauksissa. Siksi mittarimäärittely kuuluu jokaiseen Power BI - raportoinnin ja edistyneen analytiikan hankkeeseen.
Luokkamuuttujien koodaus ennustemalleissa
Useimmat ennuste- ja koneoppimisalgoritmit tarvitsevat numeerisen syötteen, joten luokka- ja järjestysmuuttujat koodataan ennen mallinnusta. Moni työkalu tekee sen käyttäjältä piilossa. Koodaus ratkaisee, olettaako malli järjestyksen, jota ei ole, ja mitä mallin kertoimet tarkoittavat.
Yleisimmät koodaustavat ovat nämä:
- One-hot-koodaus tekee jokaiselle luokalle oman 0/1-sarakkeen. Se sopii puumalleihin, regularisoituihin malleihin ja neuroverkkoihin.
- Dummy-koodauksessa yksi luokka on referenssi, ja kertoimet kertovat eron siihen.
- Efektikoodauksessa kertoimet kertovat poikkeaman luokkien keskiarvosta.
- Järjestyskoodaus kokonaisluvuilla sopii järjestysmuuttujille, kun tasaväliset askeleet ovat hyväksyttävä oletus.
- Kohdekoodaus (target encoding) korvaa luokan tavoitemuuttujan keskiarvolla kyseisessä luokassa. Se sopii muuttujille, joilla on paljon luokkia, kuten postinumerolle. Koodaus sovitetaan vain opetusdataan, jotta tavoitemuuttujan tieto ei vuoda malliin.
- Syklinen koodaus kuvaa kellonajan, viikonpäivän tai kuukauden sini- ja kosinitermeillä. Kello 23:n ja kello 01:n keskiarvo ei ole puolipäivä.
Energiankulutuksen ennustemallissa tunti ja viikonpäivä ovat syklisiä muuttujia ja ulkolämpötila välimatka-asteikollinen, joten kukin tarvitsee oman käsittelynsä.
Referenssiluokka vai keskiarvo?
Koodaustapa ratkaisee, luetaanko tulokset suhteessa yhteen referenssiluokkaan vai poikkeamina keskiarvosta. Esimerkissä tilauksen keskiarvo on Pohjoisella alueella 60 €, Etelässä 80 € ja Lännessä 70 €, ja alueilla on yhtä monta tilausta.
- Dummy-koodaus, Pohjoinen referenssinä: vakiotermi 60, Etelä +20 ja Länsi +10.
- Efektikoodaus: vakiotermi 70 eli alueiden keskiarvojen keskiarvo, Pohjoinen −10, Etelä +10 ja Länsi 0.
Molemmat mallit antavat samat aluekohtaiset ennusteet. Dummy-koodauksen mukaan Etelän tilaukset ovat 20 € suurempia kuin Pohjoisen, efektikoodauksen mukaan 10 € suurempia kuin keskimääräisen alueen.
Työkalujen oletukset eroavat
- R käyttää järjestämättömille luokille oletuksena dummy-koodausta, jossa referenssi on ensimmäinen luokka, ja järjestetyille luokille polynomikontrasteja.
- Pythonin statsmodels käyttää kaavarajapinnassa oletuksena dummy-koodausta.
- scikit-learnin OneHotEncoder tekee oletuksena sarakkeen jokaiselle luokalle.
- scikit-learnin OrdinalEncoder järjestää luokat aakkosjärjestykseen, jos järjestystä ei anneta. Tyytyväisyysluokat saavat silloin koodit järjestyksessä erittäin tyytymätön, erittäin tyytyväinen, neutraali, tyytymätön, tyytyväinen, joten "erittäin tyytyväinen" saa pienemmän koodin kuin "tyytymätön".
Koodatut tulokset kannattaa raportoida näin:
- Nimeä koodaustapa ja referenssiluokka.
- Näytä liiketoiminnalle ennustetut arvot luokittain, älä pelkkiä kertoimia.
- Valitse referenssiksi merkityksellinen lähtötaso, kuten nykyinen prosessi tai suurin asiakassegmentti, äläkä aakkosissa ensimmäistä luokkaa.
Kun ennustemalli tai koneoppimismalli viedään tuotantoon, koodaus kirjataan dokumentaatioon muuttujien ja mallin version rinnalle. Silloin tulokset luetaan samalla tavalla myös vuoden päästä.
Mittaamisen laatu
- Puuttuva ei ole nolla. Puuttuva myyntirivi voi tarkoittaa nollamyyntiä, suljettua myymälää tai epäonnistunutta latausta.
- Erikoiskoodit eivät ole arvoja. Koodit 0, −1 ja 999 vääristävät jokaista tunnuslukua, jos ne lasketaan lukuina. Koodaa "ei osaa sanoa" omaksi luokakseen tai puuttuvaksi arvoksi, älä neutraaliksi.
- Mittaustavan muutos katkaisee aikasarjan. Kun asteikko vaihtuu 1–5:stä 0–10:een tai seurantatagi toteutetaan uudelleen, raporttiin syntyy trendi, jota ei ole, ja ennustemalli oppii sen.
- Lisädata ei korjaa systemaattista virhettä. Miljoona riviä, joiden aikaleimat ovat aikavyöhykevirheen takia tunnin pielessä, ovat kaikki väärin samalla tavalla. Virheen löytää täsmäyttämällä datan riippumattomaan lähteeseen, kuten pääkirjaan.
Tarkistuslista muuttujille ja mittareille
- Käsite, operationaalinen määritelmä ja havaintoyksikkö on kirjattu.
- Mitta-asteikko on kirjattu tietotyypistä riippumatta.
- Numeerisella arvolla on yksikkö, ja rahamäärästä tiedetään valuutta, arvonlisävero sekä brutto tai netto.
- Järjestysmuuttujalla on dokumentoitu järjestys ja lajittelusarake.
- Luokkakoodit on tallennettu tekstinä, eikä niitä summata.
- Jokaisella mittarilla on summattavuus ja koostesääntö, ja osuudet lasketaan summista.
- Puuttuvat arvot ja erikoiskoodit käsitellään samalla tavalla kaikkialla.
- Mallin koodaustapa ja referenssiluokka on nimetty.
- Määritelmät on versioitu, ja mittaustavan muutokset on merkitty aikasarjoihin.
Kun nämä on kirjattu, sama muuttuja tarkoittaa samaa raportissa, ennustemallissa ja data-agentin vastauksessa.


 Ready Solutions - Asiantuntijat ja yhteyshenkilöt


 Ready Solutions - Muita referenssejä

 Tilaaja suosittelee!


 Ready Solutions - Muita bloggauksia


 ite wikin yrityshaku »
 Kaikki it-alan työpaikat »
 ite wikin referenssihaku »
 Kaikki it-alan tapahtumat »
 ite wikin julkaisuhaku »