Tekoäly tarvitsee dataa. Mutta voiko dataan luottaa?
 Tekoälyn käyttöönotossa puhutaan paljon malleista, tietoturvasta, tietosuojasta ja sääntelystä.
Yksi kysymys jää helposti vähemmälle huomiolle:
Voiko tekoälyn käyttämään tietoon luottaa?
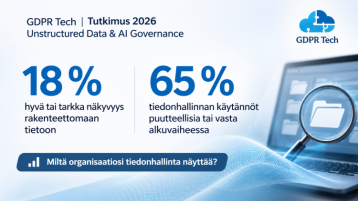
GDPR Techin käynnissä olevassa kansainvälisessä tutkimuksessa selvitämme, miten organisaatiot hallitsevat rakenteetonta tietoa ja millaisia riskejä tekoälyn lisääntyvä käyttö siihen tuo.
Vastauksia on nyt kertynyt hyvin Suomesta ja kansainvälisesti, ja yksi alustava havainto erottuu aineistosta: organisaatiot vaikuttavat olevan aidosti huolissaan tiedon laadusta.
Huoli on varsin ymmärrettävä.
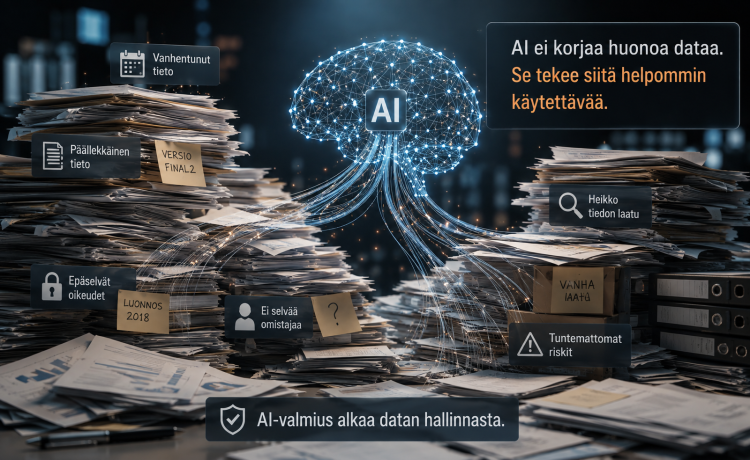
Organisaatioiden SharePointissa, Teamsissa, OneDrivessa, tiedostopalvelimilla ja muissa ympäristöissä on vuosien aikana kertynyttä tietoa. Osa siitä on ajantasaista ja tarpeellista. Osa vanhentunutta, päällekkäistä, puutteellista tai vailla selvää omistajaa.
Ihminen osaa usein suhtautua tällaiseen tietoon epäillen. Tekoäly ei välttämättä osaa.
Jos tekoälylle annetaan pääsy suurempaan osaan organisaation tietomassasta, vanha ongelma ei katoa. Sen vaikutus voi päinvastoin kasvaa.
AI ei korjaa huonoa dataa. Se voi levittää sen virheet entistä laajemmalle.
Siksi AI-valmiudessa ei ole kyse vain siitä, mitä tekoälyratkaisua organisaatio käyttää. Yhtä tärkeää on ymmärtää, millaiseen tietoon ratkaisu pääsee käsiksi ja kuinka luotettavaa tuo tieto on.
Tutkimuksemme on nyt loppusuoralla. Jos työskentelet tiedonhallinnan, tietosuojan, tietoturvan, tekoälyn tai digitaalisen kehittämisen parissa, vielä ehdit mukaan. Kysely on avoinna 9.9.2026 asti.
Osallistu tutkimukseen (no spam, no sales)
https://link.webropol.com/s/GDPR-Tech-2026-6
Julkaisemme ensimmäisen koosteen tutkimuksen tuloksista GDPR Techin verkkosivuilla syyskuun puolivälissä.
Kuva: luotu tekoälyllä.


 GDPR Tech - Asiantuntijat ja yhteyshenkilöt
 GDPR Tech - Muita referenssejä
 GDPR Tech - Muita bloggauksia


 ite wikin yrityshaku »
 Kaikki it-alan työpaikat »
 ite wikin referenssihaku »
 Kaikki it-alan tapahtumat »
 ite wikin julkaisuhaku »